
AIと人間を区別する 新しいCAPTCHA技術について
情報システム学部 情報セキュリティ学科 教授 武仲 正彦タケナカ マサヒコ
#AI #サイバーセキュリティ #ネットワークセキュリティ
- Q.01研究を行われているテキストベースCAPTCHA(OCRベース)に着目されたきっかけについて教えてください。
-
この研究テーマは、毎週行うゼミの勉強会で新しい技術を紹介・議論しているなかで、「イルージョンCAPTCHA」について触れ、学生が興味を持ったことが最初のきっかけでした。既存のCAPTCHA作成の手法は、GPUを使って画像処理が必要になるため、実装コストが高いという問題がありました。そこで、イルージョン(錯視)に着目し、例えば図形の配置によって本来存在しないものが見えたりする現象のように、「人間には読めるけれど、AIには読めない文字がつくれるのではないか」という仮説から実験を始めてみると、イル―ジョンCAPTCHAを起点に、テキストを画像化し白い文字を重ねることで、AIをより混乱させられるという気づきも得られ、想像以上にAIに対する耐性が高い結果がでたため、研究を本格的に進めることになりました。
- Q.02CAPTCHAはいつ頃から使われてきたものでしょうか?
-
CAPTCHAは、インターネット上の悪質なアクティビティにボットを使用するハッカーが蔓延している問題への対処として、1990年から2000年初頭にかけて、世界の様々なグループがCAPTCHAテクノロジーを開発してきました。実用例として、チケットを販売する際に、機械が自動的に大量にチケットを予約してしまうことを防ぐ目的として、人間とロボットを識別するところから始まりましたが、セキュリティが弱い部分が課題でした。また、技術の発展により、自動化機械ロボットが進化し、はじめは歪んだ文字を人間しか読めなかったものが、人間より機械の文字解読技術が発展したため、テキスト型のCAPTCHAは使われなくなってきました。代わりに、Googleなどが本人認証で導入している画像ベースのreCAPTUREが主流になりましたが、AIの発達により画像認識もできるようになってきたため、賢くなってきたAIを騙すという視点に着目し、実験を進めてきました。
- Q.03発表された論文において、最新のAI(視覚言語モデル(VLM))の進化に対抗するため、AIの「注意」や「知覚」そのものを欺くというアプローチが非常に興味深いと感じました。現在取り組まれている新しいテキストベースCAPTCHAは、具体的に人間のどのような「能力」と、AIのどのような「弱点」の差を利用した技術になりますか?
-
人間の錯視そのものは、実在しないものを人間が見てしまうことなので、どちらかというと「人間のエラー」ということになります。人間は主観的輪郭や過剰認識により文字を知覚できる一方、AIは背景の情報量の多い部分に注目する傾向があり、正しい文字を識別できません。この人間の錯視と、AIの認識特性の違いを利用することで、AIによる自動解読を困難にしました。具体的には、背景を高密度なテキストで埋め、その上に白文字を重ねることで、人間には読めるがAIには読み取りにくい状態を作り出しました。また、本手法は高度な画像生成技術を必要とせず、基本的な画像処理のみで生成可能である点も特徴といえます。
- Q.04本研究で開発されたCAPTHA技術と、既存のCAPTCHA技術(歪み文字型、画像選択型など)と比べた際の、技術的特徴・強み や、課題を教えてください。
-
技術的特徴として、歪み文字と同じぐらいの低コストで作ることができ、汎用的なAIに対しては非常に高い耐性をもつため、AIとの認識の差を出しやすい部分が特徴といえます。また、既存のCAPTCHAシステムに比較的容易に組み込めることも特徴といえます。
課題としては、人間にとって読みにくくなる場合があるため、フォントやサイズ、表示環境による違いなど、ユーザビリティの最適化が必要になります。また、特定のCAPTCHAに特化して学習したAIに対しては、将来的に解読される可能性も否定できず、継続的な改善が求められます。
こういった課題への対策として、コストをかけてセキュリティの強度を高める方法も考えられますが、AIの急速な進化により、人間のかわりにAIがアクセスするケースでは、CAPTCHAが有効に機能しない課題も生じてきます。さらに、本分野はAIの加速度に対して研究の追随が十分でない側面があり、不確実性やリスクが高い点もことも課題として挙げられます。 - Q.05これまでに行われた実験や、実験により得られた検証結果を教えてください。
-
現在、論文発表のための追加実験を行っており、研究は実験段階から実証段階へと進みつつあります。まず、人間に対する評価としては、読みやすさや回答時間などのユーザビリティに関するデータを収集しており、実際にどの程度ストレスなく利用できるかを明らかにすることが重要な課題となっています。
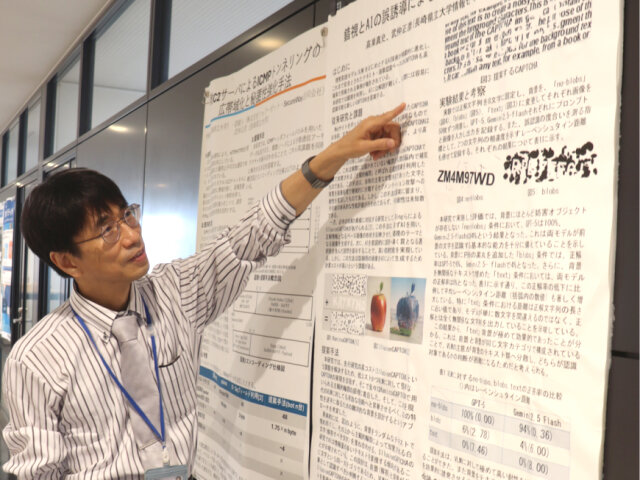
一方、AIに対する評価では、複数の視覚言語モデル(VLM)を用いた大規模な検証を実施しました。約1,800件のCAPTCHA画像を用いて比較実験を行った結果、通常の文字画像ではAIは99〜100%の精度で正しく解読できました。しかし、提案手法ではすべての条件において完全一致の正答率が0%となり、AIが正しく読み取ることは一度もありませんでした。
さらに、AIへの指示(プロンプト)を変えたり、推論能力を強化したり、画像を縮小して特徴を抽出しやすくする前処理を行っても、解読性能は改善されませんでした。これらの結果から、この手法が現在の主要なAIに対して非常に高い耐性を持つことが確認されています。実証実験の結果については、2026年10月の国内学会で発表を予定しています。 - Q.06この技術が最も適用しやすい領域(業界・サービス)はどの領域だとお考えですか?
-
この技術は、現在CAPTCHAが利用されているさまざまな場面での活用が期待されます。例えば、アカウント登録時のボット対策や、不正アクセスの防止、チケットの大量購入といった問題への対策などです。既存のreCAPTCHAなどと比べて、より簡便に導入できるケースも想定されます。
一方で、近年は二要素認証など別の認証手法への移行も進んでおり、CAPTCHA自体の役割も変化しつつあります。Google社などの再認証手法が進化する中でCAPTCHAが長期的に生き残るかは不確実ですが、AIエージェントがアクセスしてくる時代には「人間かAIか」だけでなく「AI間の認識差」を活用する方向性も検討していく必要があると考えています。その中で、この研究は「人間とAIの違いをどう扱うか」という、より根本的な問題に関わるものとして位置づけられます。 - Q.07共同研究を行う場合、企業側にはどのような役割を期待しますか?
-
CAPTCHAの実証においては、実際に利用してもらいアンケート等によるデータ収集を行うためのフィールドの確保が重要です。特に、実運用環境でのデータ取得が不可欠であることから、企業との連携が期期待されます。
一例として、自動運転の分野はAIと人間の認識の差をうまく使えるようなテーマとなり、CAPTHAの部分は一部分にはなりますが、AIと人間の認識の差について自動運転の領域で共同研究を希望する方がいればぜひ歓迎したいです。この領域では、人間に対する注意がAIにとって本当に注意と認識されるのかなど、人間の認知心理の領域にも関係してくるので、研究開発を希望する企業さんなどがいらっしゃれば、コラボレーションをやってみたいと思っています。 - Q.08今後の展望(学会発表、特許、実証実験など)を教えてください。
-
現在は、さらなる実験を進めながら論文化を進めており、国内学会での発表も予定しております。また、特許も出願済みです。今後は、ユーザビリティ評価やより強力な攻撃条件での検証に加え、専用AIによる解読への耐性評価も重要なテーマとなります。さらに、この研究はCAPTCHAにとどまらず、「人間とAIの認識差」を活用した新しいセキュリティ技術や、AI同士の識別技術といった領域への応用も視野に入れています。
これからは、人間とAIの違いだけでなく、AI同士の違いをどう扱うかも重要になってくるため、研究領域の広がりは今後さらに大きくなる可能性があります。